搜索到
71
篇与
的结果
-
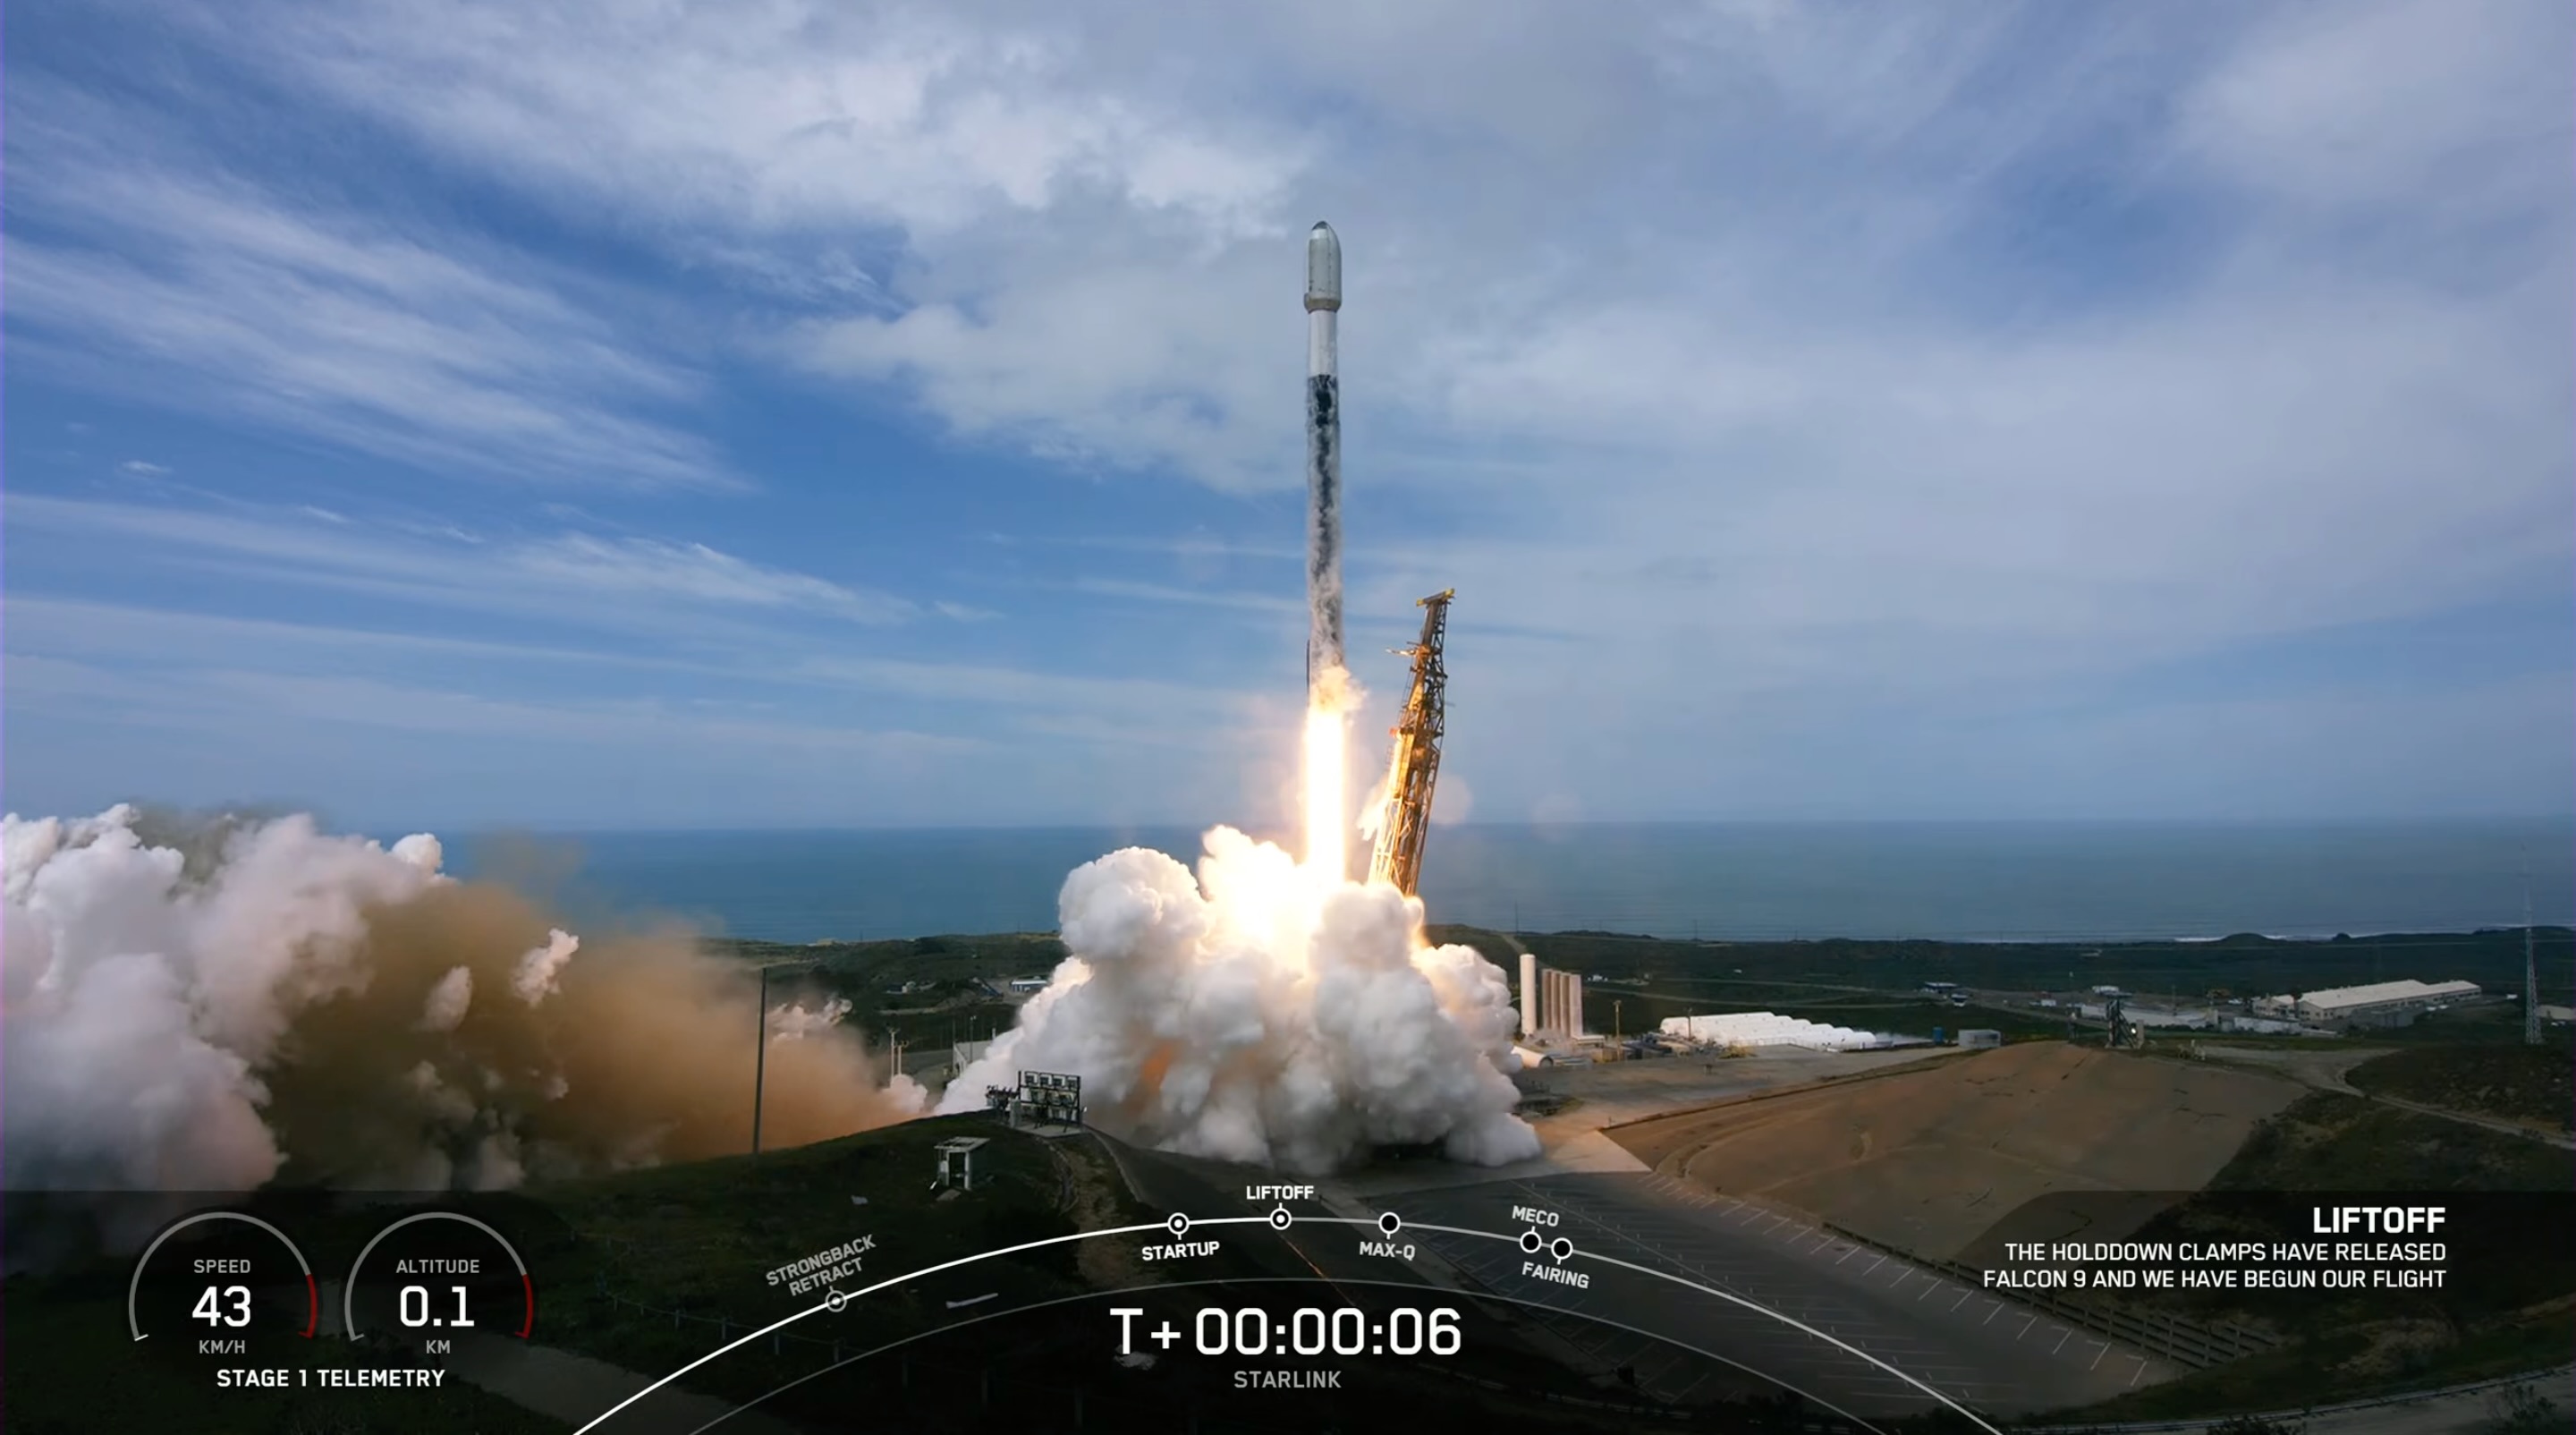
 SpaceX算力服务器——马斯克要造一个太空云计算帝国? 今天早上刷到一条消息:SpaceX正在和美国国防部洽谈提供数据中心算力服务,交易规模可能达数十亿美元。你没看错,就是那个造火箭、搞星链的SpaceX,现在要卖算力了。目录 这消息到底有多炸? SpaceX的算力底牌有多大? 星链 + 星舰 + 数据中心 = 什么? 这对我们服务器买家意味着什么? 总结 这消息到底有多炸?老实说,我看到这条新闻的第一反应不是"哇,SpaceX好厉害",而是——马斯克这盘棋下得是真大。2026年7月18日,多家媒体报道,SpaceX正与美国国防部洽谈提供AI算力服务。注意,不是火箭发射,不是卫星通信,而是数据中心算力。他们要帮五角大楼运行AI模型。你可能觉得:这不就是一个商业合同吗?有什么好大惊小怪的。但你仔细想想这个逻辑链条——SpaceX是一家航天公司。一个造火箭的公司,现在要给全球最强大的军队(和最有实力的科技公司)提供AI计算能力。这背后意味着什么?马斯克正在把SpaceX从一个"运输公司"变成一个"计算公司"。你看他这几年干了什么: Starlink星链——已经发射了6000多颗卫星,覆盖全球的卫星互联网 Colossus数据中心——在孟菲斯部署了10万块英伟达GPU的超算集群 与谷歌签约——提供约11万颗英伟达芯片的云服务 给Anthropic供算力——300兆瓦计算能力,喂给Claude背后的公司 这不是东一榔头西一棒子,这是一条清晰的路线图:从地面到太空,从通信到计算,全部自己搞定。SpaceX的算力底牌有多大?很多人以为SpaceX就是造火箭的,技术上也就是个推进器公司。但如果你看看它手里的牌,你会发现——这家伙的算力基础设施,可能比很多云厂商都要硬核。目前已知的算力布局:孟菲斯Colossus集群 - 约10万块英伟达GPU - 300兆瓦电力容量 - 已经给Anthropic等AI公司提供算力xAI的算力布局 - 2024年Grok训练的算力集群就已经达到10万块H100级别 - 还在快速扩建中与谷歌云的合作 - 提供约11万颗英伟达芯片 - 多年期合约,金额不对外公布你看这些数字。10万块GPU是什么概念?对比一下: 项目 GPU数量 说明 SpaceX Colossus ~10万块 AI训练集群 xAI训练集群 ~10万块 Grok训练用 国内主流云厂商单集群 几千~1万块 多数企业级 SpaceX手里的算力,已经是世界级的了。而且你想,SpaceX为什么要囤这么多GPU?它只是一家火箭公司,为什么要搞超算?答案只有一个:马斯克从一开始就没打算只做火箭生意。试想一下,当你有6000颗低轨卫星,有全球最低延迟的卫星网络,有地面超算集群,有火箭运输能力(星舰一次可以运几百吨货物到太空),你能做多少事?你会发现,这个组合太可怕了。星链 + 星舰 + 数据中心 = 什么?这就是我真正想说的——马斯克在构建一个"天地一体化"的算力网络。星链提供了全球覆盖的通信管道。不管你在南极还是撒哈拉,只要有星链终端,就能接入网络。延迟比传统卫星低得多(目前已经能做到20ms以内)。星舰提供了运力。未来的星舰一次可以把几百吨的设备送到近地轨道,这意味着——你可以把服务器送到太空去。太空数据中心不是科幻小说,SpaceX已经在路上了。地面数据中心提供了大规模计算能力。Colossus集群就是干这个的。这三者结合,你能得到什么?一个部署在全球(甚至太空)的分布式计算网络。任何地方,任何时间,都能调用算力。你信不信,再过5年,SpaceX很可能会推出一个叫"Starlink Cloud"的东西—— 你在网页上一键下单 算力通过星链卫星分发 地面数据中心负责计算 延迟比任何传统云服务都低 覆盖范围比任何云厂商都广 这不香吗?这对我们服务器买家意味着什么?好了,前面吹了那么多SpaceX,现在说点实际的——这跟我们买服务器的有什么关系?我的判断是:短期没什么影响,但长期来看,SpaceX入局算力市场会改变游戏规则。1. 竞争加剧,价格可能更便宜现在云服务器市场已经是红海了:AWS、Azure、Google Cloud、阿里云、腾讯云……卷得不行。如果SpaceX再加入进来,供应更多,算力单价只会越来越低。这对我们这些买家是好事。不管是买VPS还是租GPU,价格下行是大概率事件。2. 边缘计算会变成现实传统云服务的问题是什么?延迟。你在北京访问AWS新加坡的服务器,延迟至少100ms+。但星链的全球延迟能做到20-30ms。这意味着什么?未来的应用可以真正"全球部署"了。 一个在新加坡的用户和一个在纽约的用户,访问同一个应用,体验几乎没差别。这对跨境电商独立站、全球游戏服务器、实时协作应用来说,是质的变化。3. 新需求催生新产品SpaceX如果推出算力服务,最有可能先从这几个方向切入: 国防/政府客户(已经在谈了) AI训练/推理(已经在做了) 全球边缘计算节点(想象空间最大) 灾备/高可用(卫星网络的天然优势) 等SpaceX把toG(政府)和toB(企业)做通了,to小B(中小站长)的入门级产品还会远吗?总结写这篇文章的目的不是说让大家现在就买SpaceX的算力服务(人家还没正式开卖呢),而是想传达一个观点:算力正在变成像水电一样的公共基础设施。SpaceX的入场,就是这条路上最重要的标志性事件之一。想想看: 100年前,你要用电得自己建发电机 50年前,你要用算力得自己买大型机 20年前,云服务出现了,按需付费 现在,算力正在变得无处不在,甚至来自太空 马斯克走的路很清楚:星链铺管道,星舰扩展能力,数据中心做计算。他不只是要发射卫星,他要重新定义"云计算"三个字。对我们在国内做服务器导购的来说,关注SpaceX的算力布局,就是在关注未来3-5年服务器行业的走向。供你参考。(全文完)
-
AWS 1.5 万亿美元账单刷屏!云服务器的计费陷阱,你踩过几个? 昨天一个做独立站的朋友甩给我一条新闻链接,标题写着"网友收到 1.5 万亿美元 AWS 账单"。他问我:"耗子哥,这事儿靠谱吗?我最近也在看云服务器,会不会也踩这种坑?"我笑了笑,跟他说:靠谱,但不完全是你想的那样。目录 一、1.5 万亿美元账单是怎么回事? 二、计费陷阱一:按量计费的"温柔一刀" 三、计费陷阱二:你以为关掉了,其实还在跑 四、计费陷阱三:流量费才是真正的"隐形刺客" 五、计费陷阱四:看似便宜的低配,附加服务让你破防 六、服务器导购的避坑实战指南 七、总结 一、1.5 万亿美元账单是怎么回事?先说说这个新闻本身。7 月 18 号,英国卫报报道了一个事:AWS 的计费系统出了 Bug,导致部分用户收到了天价账单。有多夸张? 英国一个慈善机构,平时每月账单不到 1 英镑,结果这个月才过了一半,账单显示 78 亿美元 另一位网友 @Bharath 晒出的截图更离谱,使用量比上个月增加了 745,728,201,771%,账单金额 1.5 万亿美元 一个经营历史博客的历史学家,平时月账单 15 美元,这次收到 2450 亿美元 AWS 后来承认是 Cost Explorer 的计费数据预估出了问题。但是—— 你千万别看完就当个段子滑走了。这个 Bug 确实是 AWS 的问题,最终不会真的扣那么多钱。但我要跟你说的是另一件事:云服务器的计费陷阱,从来都不是靠 Bug 来坑你的。它光明正大地写在定价页面上,但你没看,或者看了没看懂。我做了八年服务器导购,见过太多人因为计费问题翻车。今天借这个热点,跟你聊聊云服务器/VPS 的那些计费陷阱,以及怎么避开。二、计费陷阱一:按量计费的"温柔一刀"先问你一个问题:你买云服务器的时候,是选包年包月还是按量计费?很多人觉得:"我业务量不大,按量计费灵活,用多少付多少,不浪费。"道理没错。但实际操作上,按量计费是云厂商利润最高的计费模式,没有之一。试想一下:一台 4C8G 的云服务器,包年包月可能也就 500 块/月。但如果按量计费,单价可能是 2-3 块/小时。你觉得你一天会开多少个小时?老实说,我见过太多人犯这个错:买了一台按量计费的服务器做测试,测完后忘了关机。一个月后收到账单——两千多块。你以为的"用多少付多少",实际上是"忘一次就破产"。所以我的建议很简单:能用包年包月,就别按量计费。按量计费只适合弹性扩展的临时节点,不适合主力业务。如果你真的需要按量计费,一定要设置预算告警。AWS、阿里云、腾讯云都有这个功能,设定一个月的预算上限,超过就发短信/邮件通知你。别省这一步。三、计费陷阱二:你以为关掉了,其实还在跑这个坑踩的人最多。举个例子:你在云平台上创建了一个 VM(虚拟机),测试完了,觉得不需要了,你点了"停止"。——你以为这就完了?云厂商告诉你:停止的实例,系统盘和数据盘依然占用存储空间,快照也在,公网 IP 可能还在保留。这些都是要收费的。更狠的是,有些厂商的"停止"实际上是"关机不释放资源"。CPU 和内存确实不收费了,但云盘、弹性 IP、快照照常计费。我去年帮一个客户做成本审计,他在 AWS 上停了 6 台 EC2,结果每个月还在扣 800 多美金。查了半天,是 6 块各 500G 的 EBS 云盘和一堆自动快照在收费。怎么破? 彻底释放资源:不用的实例直接"销毁"或"释放",别只"停止" 关联资源一并清理:删除实例时,把绑定的云盘、弹性 IP、快照一起删掉 定期检查闲置资源:每季度登录控制台,看看有没有"僵尸资源" 这就像你退房的时候,不只是把房卡还给前台,还得把冰箱里的东西清空、把水电关了。不然下个月账单照样寄给你。四、计费陷阱三:流量费才是真正的"隐形刺客"CPU、内存、硬盘的价格,都明明白白写在配置单上。但流量费——这才是云厂商真正赚钱的地方。你看一下各大厂商的带宽定价: 厂商 固定带宽(1Mbps) 按量流量单价 AWS ~3 美金/月 ~0.12 美金/GB 阿里云 ~23 元/月 ~0.8 元/GB 腾讯云 ~20 元/月 ~0.8 元/GB 乍一看不贵?但问题是,你根本不知道自己一个月会跑多少流量。我见过一个做跨境电商图片站的哥们,用了按量流量计费,一个月跑了 200GB——账单多了 1600 块。他之前完全没概念,以为 200GB 就是刷刷网页的量。200GB 如果是静态资源网站访问,那可能是几十万次 PV 了。还有个更隐蔽的坑:公网 IP 本身的费用。 很多厂商的弹性公网 IP,你不绑定到实例也要收费——每个月几十块。你手上有三五个闲置 IP,那就是几百块打水漂。避坑建议: 小型网站用固定带宽,1Mbps 对个人站够用了 大流量业务用按量,但要设置流量上限告警 不用就释放弹性 IP,别留着过年 用好 CDN,回源流量走内网(便宜很多),用户访问走 CDN 节点 四(其实是五)、计费陷阱四:看似便宜的低配,附加服务让你破防很多用户选服务器时只盯着 CPU、内存、硬盘这三个指标,觉得"2C4G 只要 99/月,真香"。结果用起来发现,一堆"基础服务"都是另外收费的: 快照服务:自动备份系统盘,按存储容量收费 安全服务:基础防护免费,高级版按实例收费 监控服务:基础监控免费,精细化监控额外收费 日志服务:收集系统日志,按存储量和写入次数收费 DDoS 高防:超过基础阈值后按清洗流量收费 你说这些服务重不重要?重要。 一个都不开,出事了哭都来不及。但全开了,你的月度账单可能翻 2-3 倍。这里我的建议是:做服务器导购这些年,我总结了一个经验——标价 × 1.5 ≈ 实际月消费。这是针对中小型网站最保守的估计。选配置的时候,别只看标价。去翻翻厂商的价格计算器,把快照、安全、监控这些基础服务都勾上,看看最后的总价能不能接受。六、服务器导购的避坑实战指南前面说了这么多陷阱,最后给你一份实战指南。不管你买哪家的云服务器,按这个步骤走,踩坑的概率至少降低 80%。第一步:明确需求 个人博客 / 小型网站:1C2G 起步,固定带宽 1-3Mbps 电商 / 中等流量:2C4G 起步,带宽 3-5Mbps,考虑上 CDN AI 推理 / 机器学习:上 GPU 实例,别想着用 CPU 硬扛 数据库 / 中间件:选高 IOPS 的云盘,不要用普通云盘 第二步:选计费模式 主力业务 → 包年包月 临时任务 → 按量计费,设预算告警 大促弹性扩展 → 按量 + 弹性伸缩组 第三步:看总价,不看标价用厂商的计价器算一下全量费用。阿里云叫"价格计算器",腾讯云叫"计费中心",AWS 叫"Pricing Calculator"。把云盘、快照、带宽、安全服务都加进去。第四步:设置预算和告警 设置月度预算上限 设置 50%、80%、100% 告警阈值 绑定手机号/邮箱接收通知 第五步:定期体检 每月检查一次闲置资源 清理无用快照和镜像 回收未绑定的弹性 IP 七、总结AWS 1.5 万亿美元账单这事,是一个 Bug,也是个提醒。真正的计费陷阱从来不需要 Bug 来帮忙——它一直写在 SLA 里、藏在配置项中、埋伏在你随手点的"下一步"按钮后面。你不需要成为云计算的专家才能买对服务器。你需要的是: 知道钱花在哪了(理解计费项) 知道怎么控制(设置预算和告警) 养成检查的习惯(定期清理闲置资源) 就这么简单。我做了八年服务器导购,帮上千个客户选过服务器。我自己最常用的配置也就是 2C4G 加个 5M 带宽,一台机器跑了四个网站,稳得很。别被参数和价格牵着走,搞清楚自己到底需要什么,再下手。希望对你有用。(全文完)如果你正在纠结买哪家的服务器,欢迎来找我聊聊。八年导购经验,帮你省的不只是钱,还有踩坑的时间。
-
AI绘画云服务器选购指南:从Stable Diffusion到ComfyUI,你的显卡真的够用吗? 目录 WAIC 2026给我的一点小震撼 AI绘画到底吃的是什么硬件? AI绘画云服务器的"三重陷阱" 你的场景决定了你的配置 三套经过验证的配置方案 总结——不要为你的想象力设限 WAIC 2026给我的一点小震撼老实说,这几天在上海举办的WAIC 2026(世界人工智能大会),确实给了我一些震动。华为昇腾950超节点拿了SAIL奖,1024卡规模、1 EFLOPS算力、256TB共享内存——数据确实漂亮。东方算芯也拿出了全球首颗软件定义近存计算3D AI芯片DF1000,14nm工艺下干到520 TFLOPS。你看,这些大厂在台上讲的是"大算力""超节点""国产替代",讲得慷慨激昂。但作为一个每天跟服务器、VPS打交道的人,我更关心另一件事:这些算力红利,什么时候能落到普通人头上?具体一点——你是一个设计师、一个自媒体人、一个想用Stable Diffusion做点副业的程序员。你不需要1024卡超节点,你只需要一张能流畅跑SD XL、能跑ComfyUI工作流的云显卡。这个问题,大厂不太会替你考虑。但今天这篇文章,我就把这个事彻底讲透。AI绘画到底吃的是什么硬件?先把话说明白:AI绘画对服务器的需求,和做AI对话、跑大语言模型,完全是两码事。大语言模型(LLM) 吃的是HBM高带宽内存和总算力,显存越大越好,通信带宽越高越好。你看现在做AI推理的云服务器,清一色推A100 80G、H100,就是这个原因。AI绘画(Stable Diffusion / ComfyUI) 吃的核心只有三个字:显存带宽。拿Stable Diffusion XL来说: 分辨率 推理显存占用 推荐显存 单张生成时间(RTX 4090) 1024×1024 8-10 GB 12 GB+ 2-3秒 2048×2048 16-18 GB 24 GB+ 6-8秒 4096×4096(放大) 24+ GB 48 GB+ 20-30秒 看到没有?分辨率上去了,显存需求是指数级增长的。而大多数人的误区就在这里——觉得CPU核多、内存大就能跑AI绘画。这是典型的用"传统服务器思维"套"AI应用场景",结果就是——买了台8核32G的高配VPS,开开心心装SD,一跑图发现OOM了。别笑,我真见过不少这样的人。所以,AI绘画云服务器的选型,第一条铁律就是:显卡>显存>内存>CPU,顺序不能乱。AI绘画云服务器的"三重陷阱"陷阱一:显存数字游戏现在很多云厂商推AI绘画套餐,标着"24G显存""32G显存",看起来很香对吧?但你仔细看一下——显存带宽是多少?同样是24G显存: - RTX 4090:带宽 1008 GB/s - RTX 3090:带宽 936 GB/s - A10:带宽 600 GB/s - T4:带宽 320 GB/s显存一样,带宽差3倍。跑一张2048的图,4090只用6秒,T4可能要20秒。所以,不要只看显存大小,更要看显卡型号和显存带宽。云厂商把低端卡配上大显存来充数,这事在业内并不少见。陷阱二:按量计费的"温柔一刀""0.5元/小时起""按量付费,不用不花钱"——听上去很美。我们来算一笔账:假设你每天用SD生成200张图,每张图耗时5秒,加上加载模型、切换参数、调试Prompt的时间,实际单张图的平均耗时约30秒。200张 × 30秒 = 6000秒 ≈ 1.67小时 / 天一个月按30天算:1.67 × 30 ≈ 50小时按0.5元/小时的入门卡(通常是T4级别)→ 25元/月听起来很便宜是吧?但问题是——0.5元/小时的卡根本跑不动你想要的效果。如果你用的是能流畅跑SD XL的卡(至少RTX 4090或A100级别),价格在8-15元/小时。15 × 50 = 750元/月是不是就没那么香了?陷阱三:你以为买了就能用?这是最多人踩的坑。AI绘画不是装个软件就能跑的。你需要: 1. Python环境 + CUDA + cuDNN + PyTorch — 版本要精确匹配 2. Stable Diffusion WebUI 或 ComfyUI 的安装和配置 3. 模型文件下载(Checkpoint、LoRA、VAE)— 一个模型就5-7GB 4. ControlNet、IP-Adapter 等扩展的安装 5. 工作流导入和调试很多云厂商提供"预装镜像",我劝你一定要问清楚: 镜像是什么版本的? 2024年的镜像可能连SD XL都跑不顺 模型更新了吗? 装的是多少个月前的老模型? 插件全不全? ControlNet、AnimateDiff这些关键扩展有没有? 你的场景决定了你的配置AI绘画的场景差异非常大,一台机器不可能通吃所有需求。我按使用场景给你三套方案:场景一:个人玩玩,入门体验需求特征:每周用几次,生成1024×1024左右的图,跑跑SD XL自带的风格,不折腾复杂工作流。推荐配置: - 显卡:RTX 4060 / RTX 3060 级别(12G显存) - CPU:4核 - 内存:16GB - 硬盘:100GB SSD - 参考价格:300-500元/月这个级别,跑SD XL基础出图没问题,LoRA也能玩一下。但别想跑高清放大或者复杂的工作流,显存会爆。场景二:接单工作室 / 自媒体批量出图需求特征:每天批量出图,需要高清放大、ControlNet精准控制、多个LoRA叠加。需要稳定的产出效率。推荐配置: - 显卡:RTX 4090(24G显存)或 A100 40G - CPU:8核 - 内存:32GB - 硬盘:200GB SSD - 参考价格:1500-3000元/月老实说,这是目前"性价比"最高的档位。RTX 4090的性价比在AI绘画领域基本是无敌的——显存够大、带宽够高、CUDA核心够多。场景三:企业级 / 团队协作 / 视频生成需求特征:多人同时使用,需要跑AnimateDiff视频生成、高清视频转绘、批量训练模型。需要7×24稳定运行。推荐配置: - 显卡:A100 80G / H100 / 多卡并行 - CPU:16核+ - 内存:64GB+ - 硬盘:500GB+ SSD - 参考价格:5000-20000元/月这个级别已经不是在"玩"了,是在做生产的规划。你需要考虑的不只是硬件,还有团队的协作流程、数据管理、成本分摊。三套经过验证的配置方案说理论容易,给方案得罪人。但得罪人我也要说。以下三个配置方案,是我自己和几个做AI绘画的朋友亲自验证过的,绝对不是纸上谈兵。方案一:入门尝鲜 — 适合个人爱好者云服务商:阿里云 / 腾讯云 / 华为云 实例类型:GPU加速型(GN系列 / GNV系列) 配置:4核 + 16GB内存 + RTX 4060(12G) + 100GB SSD 推荐镜像:Ubuntu 22.04 + CUDA 12.1 + PyTorch 2.x 预估月费:300-500元 可以做什么:SD XL出图、简单LoRA训练、ControlNet基础控制 不能做什么:2048以上高清放大、视频生成、多人同时使用 你可能会问:为什么不用更便宜的T4?因为T4的8G显存跑SD XL很勉强,出图慢,体验差。 省下来的钱买的是"每次出图多等30秒"的体验损失。这个账,你自己算。方案二:效率优先 — 适合接单 / 自媒体云服务商:UCloud / 硅基流动 / AutoDL 实例类型:RTX 4090 云实例 配置:8核 + 32GB内存 + RTX 4090(24G) + 200GB SSD 推荐镜像:ComfyUI 官方镜像 / SD WebUI 最新版 预估月费:1500-2500元(包月)或 8-12元/小时(按量) 可以做什么:批量出图、高清放大、ControlNet工作流、多个LoRA叠加 不能做什么:训练大模型(Dreambooth全量微调)、4K视频生成 老实说,这个档位是目前AI绘画市场的甜点区。成本可控,产能可观。一个熟练的设计师用这套配置,一天出200张高质量图完全没问题。按一张商图50-100元算,200张的收入是多少?你自己算吧。成本是投入,不是消费——这个认知一定要有。方案三:生产力工具 — 适合团队 / 企业云服务商:腾讯云 / 华为云 / AWS 实例类型:A100 80G / H100 云实例 配置:16核 + 64GB内存 + A100 80G + 500GB SSD 推荐镜像:自定义Docker镜像,集成ComfyUI + AnimateDiff + 各类型模型 预估月费:5000-15000元 可以做什么:一切 不能做什么:基本没有不能做的 这个级别,已经不是"性价比"能衡量的了。你在买的是稳定性和效率。总结——不要为你的想象力设限WAIC 2026上,各种大厂在秀肌肉,1024卡超节点、3D AI芯片,数据一个个漂亮得不行。但说句实话——那些离你太远了。真正对你有用的是:找到一台适合自己需求的AI绘画云服务器,跑起来,出图,赚钱,或者做出让自己满意的作品。别被硬件参数迷了眼,也别被"按量计费""1元起用"的营销话术忽悠了。AI绘画这个赛道,还在以极快的速度发展。SD 3、SD 4已经在路上了,对硬件的要求只高不低。现在花点时间把服务器配置搞对,省下来的不光是钱,更是时间和机会。对了,最后说一句——如果你现在还在纠结"要不要上云"这个问题,那我给你一个判断标准:当你在本地跑一张图需要等5分钟以上,或者显存不够报OOM的时候——就是你该上云的时候了。别等到客户催图了才想起配服务器。别让自己墙了自己。供你参考,希望对你有帮助。(全文完)
-
AI设计芯片的时代来了:服务器硬件迭代加速,2026年买服务器该等还是上车 老实说,这篇文章我犹豫了两天才动笔。原因很简单——我最近被一个之前从没遇到过的问题给问住了。后台连着收到好几条私信,几乎都在问同一件事:"耗子叔,听说 Kimi K3 用 AI 48 小时就设计出了芯片,那我现在买服务器是不是傻了?会不会半年后就过时了?"你看,这个问题在一年前根本不会有人问。因为过去二十年,芯片迭代的节奏是确定的、可预测的——Intel tick-tock 让你知道明年会有新架构,AMD Zen 让你算得出下下代有几个 CCD。但现在不一样了。2026 年 7 月,技术圈发生的几件事,正在从根本上改变这个游戏的规则。目录 48 小时设计芯片,Kimi K3 到底干了什么? 芯片设计周期从 18 个月到 48 小时——这意味什么? 服务器硬件迭代速度要起飞了 等还是买?我的四字真言 三种场景,三种策略 写在最后:工具的宿命论 一、48 小时设计芯片,Kimi K3 到底干了什么?先给不太关注前沿动态的朋友补个课。7 月 16 日,月之暗面发布了 Kimi K3——2.8 万亿参数,MoE 架构,896 个 expert 每次激活 16 个,100 万 token 上下文窗口,原生多模态。这些数字你大概在别的地方也看到了,我就不重复了。但有一个细节,几乎所有报道都一笔带过了,却是我认为最值得深挖的:Kimi K3 跑通了完整的芯片设计流程,只用了 48 小时。什么概念?传统上,一颗芯片从架构定义到 RTL 代码,再到综合、布局布线、时序收敛、物理验证——这一整套流程,一个有经验的芯片设计团队,需要 18-24 个月。即便是最激进的 EDA 工具辅助,也很难压缩到 12 个月以内。而 Kimi K3,48 个小时。你说,这能不让人后背发凉吗?而且这还不是孤例。同期的 WAIC 2026 上,东方算芯展出了全球首颗软件定义近存计算 3D AI 芯片 DF1000,算力达到了 520 TFLOPS。美股半导体指数也已经跌入了熊市——资本市场在用脚投票,认为芯片的"稀缺性溢价"正在消失。硬件正在变得"不值钱",而其根本原因,是 AI 让硬件设计变得"太便宜"了。二、芯片设计周期从 18 个月到 48 小时——这意味什么?你可能要说:"48 小时设计芯片?那以后芯片岂不是满天飞?"理论上,是的。但这里面有一个 Core 的逻辑需要理清楚。芯片设计周期缩短,不等于芯片制造周期缩短。芯片制造是物理过程——光刻、蚀刻、封装——这些环节的周期不会因为 AI 而指数级压缩。台积电的 A14 制程还是得按部就班走,三星的 3nm 良率还是上不去。所以,关键的变化不在制造端,在设计端。设计端的变化,带来的直接影响是什么?是迭代速度——芯片的架构迭代、功能迭代、优化迭代,会快到你跟不上。过去你买一台服务器,它的 CPU/GPU 架构至少管 3-5 年。Intel 的 Ice Lake 用了两年才被 Sapphire Rapids 取代,AMD 的 Milan 用了一年半才出 Genoa。因为设计一颗新芯片太贵太慢了,大家只能"挤牙膏"。但现在不一样了。AI 把芯片设计的边际成本打到了地板价。芯片厂商可以像软件发版本一样发布芯片——v1.0、v1.1、v2.0,几个月一个版本。试想一下,如果 AMD 和 Intel 每 6 个月就迭代一次 CPU 架构,你去年买的 Zen 5 服务器,明年可能就被 Zen 6 的 1.5 倍性能按在地上摩擦。你的服务器还没折旧完,性能就被"降维打击"了。这不香吗?——对消费者来说当然香。但如果你刚花了 10 万块买了一台 GPU 服务器,三个月后出了新款,性能翻倍价格一样——你心里舒服吗?三、服务器硬件迭代速度要起飞了这不是科幻小说。迹象已经非常明显了。你看几条线:第一条:AI 芯片公司正在吃掉传统芯片公司的午餐。NVIDIA 的 H100 还没铺完,B200 就来了。AMD 的 MI300X 还没捂热,MI400 的 Roadmap 已经公布了。更不用提 Groq、Cerebras、Tenstorrent 这些新玩家,每家都在用 AI 加速自己的芯片设计。第二条:云厂商自研芯片的节奏在加快。AWS Graviton 已经走到了第四代,Google TPU 到了第六代,微软、Meta、字节全在自研。自研意味着什么?意味着他们可以针对自己的工作负载做定制化设计,然后用 AI 加速设计流程,快速迭代。第三条:美股半导体指数跌入熊市,市场在用脚投票。这说明什么?说明投资者认为芯片的"稀缺性溢价"正在消失。当芯片不再稀缺,服务器硬件必然降价。这是一个传导链条:芯片设计成本降低 → 芯片供给增加 → 硬件成本下降 → 云服务器/VPS 降价。而这,才刚刚开始。四、等还是买?我的四字真言好了,前戏够久了。我知道你最想问的是这个问题。在 AI 加速硬件迭代的时代,到底该不该现在买服务器?我的回答是四个字:"该买就买"。你信不信,这个答案看起来很敷衍,但其实是我花了十年踩坑踩出来的。2018 年的时候,我一个朋友要买 GPU 服务器跑深度学习。当时 RTX 2080 Ti 刚出,一块要一万多。他纠结了一整个月,觉得"明年 Volta 架构就要出了,现在买不是傻吗"。结果呢?Volta 确实出了。但他也等了一整年没干成任何事。别人用 2080 Ti 已经把模型训完上线了,他还在等"最佳时机"。两年后他终于买了一台 A100——但你猜怎么着?H100 的路标已经出来了。这就是"等等党"的终极困境:你永远等不到"最佳时机",但业务不会等你。硬件的铁律是:你买的不是硬件,是时间。你花 500 块一个月租一台 VPS,这一年下来不过 6000 块。但如果你因为"等降价"而错过了三个月业务窗口,这个成本可能是 6 万、60 万。当然,我说"该买就买",不代表闭着眼睛乱买。恰恰相反——正因为迭代加速,你的选购策略反而要更精明。五、三种场景,三种策略我按场景给你三个策略,直接抄作业:场景一:跑业务(网站、电商、API、数据库)策略:现在买,签长租约。你是用服务器赚钱的,不是等服务器贬值的。选一台当前性价比最高的配置(比如 AMD EPYC 平台 + DDR5 + PCIe 5.0 SSD),签 1-2 年的合约,锁定价格。机器的钱三个月的业务收入就回来了,管它明年出不出新款。核心原则:不要让硬件焦虑绑架业务决策。场景二:做 AI 训练/推理策略:按需租用,不买断。AI 硬件的迭代速度是所有场景里最快的。今天 MI300X 够用,明天 B200 就是三倍性能。买断一台 GPU 服务器是最亏的——折旧速度比你还款速度还快。所以,租算力 > 买硬件。用 Lambda Labs、Vast.ai 或者国内各大云厂商的 GPU 实例,按月租、按小时租,灵活切换。(注:这里我就不展开讲算力租赁了,之前写过一篇 AI算力租赁,有兴趣的朋友去看那篇。)场景三:个人开发/建站/VPS 轻度使用策略:买最便宜的,把"迭代焦虑"假货扔给云厂商。你这个级别的用量,硬件迭代对你根本没影响。2 核 4G 的 VPS 三年前和三年后干的活是一样的——跑个 Nginx、挂个数据库、搭个 CI/CD。芯片迭代再快,跟你的 WordPress 站点没有半毛钱关系。买最便宜的轻量云,把省下来的钱花在刀刃上。六、写在最后:工具的宿命论我最近在翻《庄子》,里面有一段话我反复读了好几遍:人皆知有用之用,而莫知无用之用也。你会发现,那些天天关心"下一代芯片什么时候出"的人,往往是最少用服务器干活的人。而那些真正在用服务器创造价值的人,根本不关心这些——他们只关心"这台机器能不能帮我赚到钱"。服务器是工具,不是藏品。AI 加速硬件迭代这件事,对行业是好事,对消费者也是好事。但它不应该成为你"不做事"的借口。别让"等待最佳时机"成为你一事无成的遮羞布。你现在手上的机器,就是最好的机器。供你参考。(全文完)
-
当马斯克开始"卖算力":SpaceX 进军 AI 算力服务,云服务器市场要变天了 老实说,当我在新闻里看到 SpaceX 正与美国国防部洽谈提供 AI 算力服务时,第一反应不是"又一个云厂商来了",而是——这条鲶鱼太大,整个池塘都得重新洗牌。目录 一个价值几十亿美元的消息 为什么是 SpaceX? SpaceX 的算力底牌:从 Colossus 到 11 万颗 GPU 对云服务器市场意味着什么? 对普通用户的直接和间接影响 我的几点建议 一个价值几十亿美元的消息2026 年 7 月 18 日,界面新闻(后经多家媒体转载)爆出一条消息:SpaceX 正与美国国防部洽谈提供数据中心算力服务,帮助运行 AI 模型,相关交易规模可能达 数十亿美元。你看,这不是什么"远期愿景"——谈判已经摆到台面上了。虽然双方还在早期阶段,尚未达成最终协议,但这个信号足够强烈:马斯克要把航天公司的算力,当成商品卖给五角大楼了。这让我想起 2018 年左右,AWS 刚拿到 CIA 那个百亿美元大单时的市场反应。当时的论调是"云市场要被 Amazon 垄断了"。结果呢?Azure、GCP、Oracle Cloud 一个个都冲了进来。而现在,SpaceX 要做的不是传统云,而是更高一层——AI 算力基础设施服务。试想一下,一个造火箭的公司开始卖算力,AWS、Azure、Google Cloud 这些老牌云厂商会怎么想?是不是?为什么是 SpaceX?很多人会问:一个航天公司,凭什么切入 AI 算力市场?来看看 SpaceX 为此布了多久的棋。2026 年 6 月,SpaceX 与 Google 签署了多年期云服务协议——你没看错,SpaceX 既是 Google Cloud 的大客户,又反过来通过自己的数据中心提供算力给第三方。这份协议的核心是:SpaceX 提供约 11 万颗英伟达 GPU 芯片及相关计算资源。换句话说,Google Cloud 负责"网络管道",SpaceX 负责"计算工厂"。这不香吗?不仅如此,头部的 AI 公司 Anthropic(Claude 的开发商)已经宣布使用 SpaceX 位于 孟菲斯的 Colossus 1 设施,获得 300 兆瓦 的计算能力。300 兆瓦什么概念?足够支撑一个小型城市的数据中心集群。你会发现一个有意思的格局: 公司 算力来源 规模 AWS 自建 + NVIDIA 百万级 GPU Azure 自建 + NVIDIA 百万级 GPU Google Cloud 自建 + NVIDIA 百万级 GPU SpaceX Colossus 设施 + NVIDIA 11万+ GPU 起步 虽然规模上暂时追不上三大云巨头,但增速是惊人的——而且 SpaceX 的差异化优势,传统云厂商根本没法复制。SpaceX 的算力底牌:从 Colossus 到 11 万颗 GPUColossus 1 并不是 SpaceX 的随机尝试,而是埃隆·马斯克在 AI 基础设施上的一步关键落子。这个位于田纳西州孟菲斯的超大规模数据中心,当初是为 xAI(马斯克自己的 AI 公司)训练 Grok 系列模型而建的。你信不信,Colossus 从奠基到投用,只用了几个月时间——这种执行力,传统云厂商看了都得叫一声"大哥"。而这背后还有一层更大的布局:SpaceX 的能源和场地优势。做服务器导购这么多年,我一直强调一个原则:云服务器的成本,七分在电,三分在硬件。SpaceX 的优势在哪?它有发射场,有广阔的闲置土地,有能源基础设施——甚至未来可以直接用太阳能或星链网络的能源来给数据中心供电。AWS 能做到吗?Azure 能做到吗?这才是真正的降维打击。对云服务器市场意味着什么?老实说,短期内 SpaceX 冲击不到普通 VPS 用户。它瞄准的是 国防部级别的超大规模 AI 训练和推理负载,不是你跑个 WordPress 博客或者挂个代理的小鸡。但长期来看,市场格局的变化会层层传导。让我拆解一下这条逻辑链: SpaceX 抢的是最顶层的超大规模算力订单(国防、企业、高端 AI 训练) 这会挤压传统云厂商的高利润空间 三大云厂商为了维持利润,会在中低端产品的定价上更激进——对中小用户其实是好事 同时,新的算力供给方入场,会加速整个行业的成本下降 你可能会问:那我是买普通的 VPS,还是等什么"SpaceX 云"?我的回答是:别等,也等不来。 SpaceX 短期内不会做低端 VPS 市场——它不靠那个赚钱。但 SpaceX 入局这件事本身,就是一个行业向下的分水岭。云服务器和 VPS 的价格还会继续降,但会越来越分化。对普通用户的直接和间接影响我把影响分成两个层面:直接影响(短期):几乎没有。 - 你不会在 VPS 商家列表里看到"SpaceX VPS"(至少这几年不会) - 不会影响你买 99 元一年的香港小鸡 - 合同、服务条款都不会因为这个消息有任何变化间接影响(中长期):产业链重构。 - NVIDIA GPU 的供需会更紧张,但整体算力供应在增加 - 云计算行业的马太效应加剧——大者恒大 - 中小云厂商会在垂直场景(游戏服务器、AI 推理等)上寻找差异化 - 硬件成本持续下降,最终惠及终端用户我做了这么多年服务器导购,看过的行业变化不少。每次有新的大玩家入场,短期是恐慌,长期是利好。我的几点建议讲了这么多,给你一些实在的建议: 如果你是普通站长: 该买啥买啥。现在的 VPS 价格已经很低了,SpaceX 入局不会让你的 1C1G 小鸡降价,但高端云服务器的性价比会慢慢提升。 如果你在选 AI 算力服务器: 再多等半年。SpaceX 这个级别的玩家入局,意味着 GPU 云服务器的竞争会更加惨烈。到时候租 GPU 跑 AI 的成本可能会降到一个你意想不到的地步。 如果你是云服务商: 留个心眼。SpaceX 这种"不按常理出牌"的选手,真正的杀手锏可能还没亮出来——毕竟它的 Starlink 可是全球最大的卫星网络,卫星与数据中心的协同,想想就知道有多大的想象空间。 保持关注。 这个行业三年一小变,五年一大变。关注我,帮你持续跟踪云服务器市场的最新动态。 最后送大家一句话:技术市场的本质一直都是——谁把算力做得更便宜、更可靠,谁就能赢。SpaceX 正在用造火箭的思维来造算力,这不是概念炒作,这是真刀真枪的行业重塑。(全文完)参考来源:界面新闻 2026-07-18《SpaceX据悉洽谈向美国防部提供AI算力服务》、公开报道的 SpaceX-Google 云服务协议及 Colossus 设施信息